Caracteres raros en DBF: cómo dar con la codificación correcta
Un archivo DBF no tiene ninguna marca que diga «esto es UTF-8». La página de códigos la nombra un único byte del encabezado o no la nombra en absoluto, y entonces hay que deducirla del contenido. Así es como «Canción» se convierte en «Canci¢n» o en «Canci¢n».
De dónde viene el problema
DBF es un formato de un byte por carácter: cada carácter ocupa exactamente un byte. Qué letra representa un byte depende de la página de códigos. La «ñ» se guarda como 0xA4 en la página DOS 437 y en la 850, pero como 0xF1 en windows-1252. Si se lee con la tabla equivocada, sale otro carácter:
| Byte | cp437 (DOS, EE. UU.) | cp850 (DOS, Europa Occidental) | windows-1252 |
|---|---|---|---|
0xA4 | ñ | ñ | ¤ |
0xF1 | ± | ± | ñ |
0xA2 | ó | ó | ¢ |
0xE9 | Θ | Ú | é |
El programa que escribió el archivo conocía su propia tabla. El programa que lo lee debe tomarla del encabezado, o adivinarla.
El controlador de idioma: el byte 29 del encabezado
El byte 29 del encabezado de un DBF (contando desde cero) contiene el Language Driver ID, un código que nombra la página de códigos. Los valores más habituales:
| Código | Codificación | Origen típico |
|---|---|---|
0x01 | cp437 | programas DOS en EE. UU., dBase y FoxPro tempranos |
0x02 | cp850 | programas DOS en Europa Occidental y en España y Latinoamérica |
0x03, 0x57 | windows-1252 | programas de Windows, Visual FoxPro |
0x64, 0x1F | cp852 | programas DOS en Europa Central |
0xC8 | windows-1250 | programas de Windows en Europa Central |
0x00 | no especificado | cerca de la mitad de los archivos reales |
El byte también puede ser incorrecto: un archivo lo creó un programa, lo amplió otro y el encabezado conservó su valor original. Es una pista sólida, no una garantía.
Cómo leer los síntomas
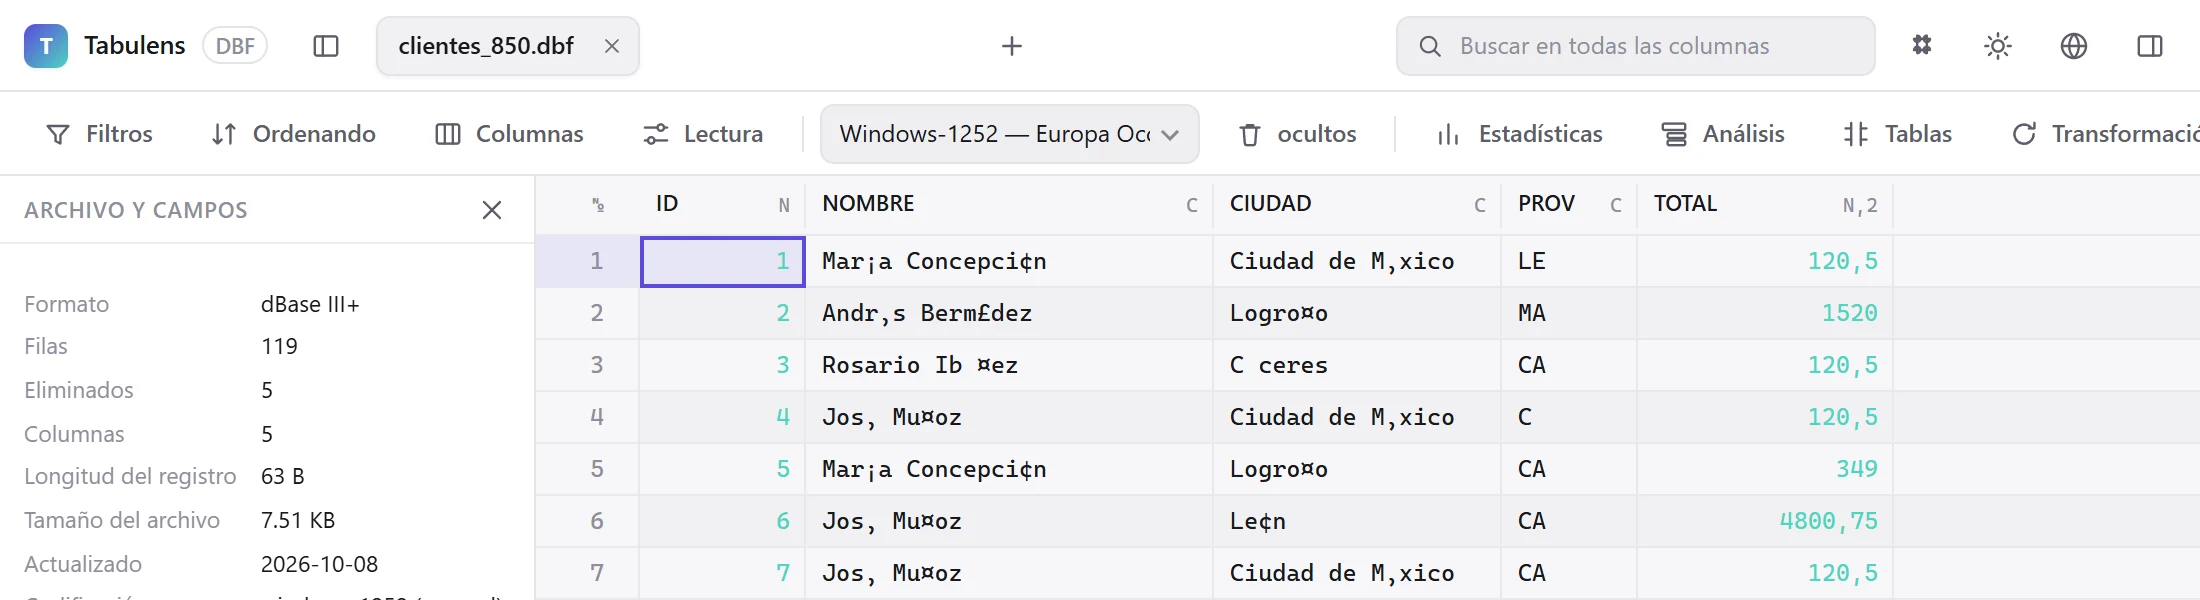
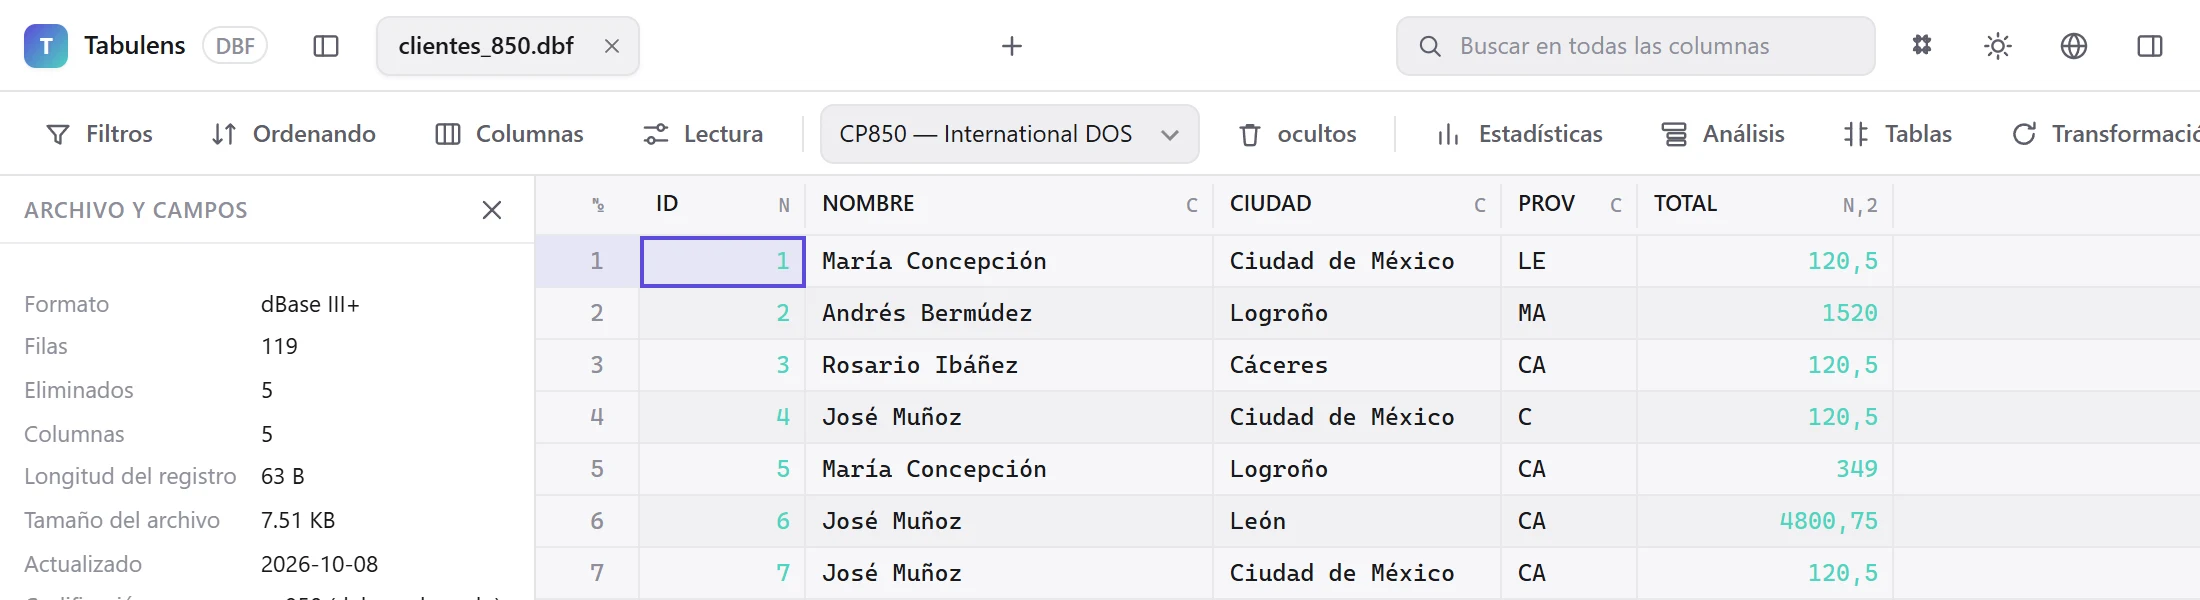
El patrón de la basura dice qué ha pasado:
- Caracteres de dibujo de cajas dentro de las palabras (
╔ ║ ╗ ╚ ╣): el archivo se escribió en una página de Windows y se lee como una de DOS. La mitad alta de las tablas de DOS está llena de caracteres para trazar líneas y las letras con tilde caen ahí. - «¢», «¤», «‚» donde debería haber ó, ñ, é: lo contrario, datos de DOS leídos como windows-1252.
- «Θ», «Ú», «±» en lugar de é o ñ: datos de windows-1252 leídos como cp437 o cp850.
- «Ã³», «Ã±», «Ã©»: dos bytes por letra: el texto es UTF-8 y se lee con una tabla de un byte. Es raro en DBF, pero las herramientas modernas lo escriben.
- Caracteres de sustitución (�): el decodificador encontró bytes que no existen en la tabla o texto multibyte cortado.
Qué hacer en la práctica
- Abra el archivo y mire los campos de texto. Si se leen bien, la codificación se tomó del encabezado o se dedujo del contenido.
- Si no, cambie la codificación en la barra de herramientas y pruebe las candidatas probables: cp437 y cp850 para archivos de programas de la era DOS, windows-1252 para los de Windows.
- Cambiar de codificación no vuelve a abrir el archivo. Solo cambia la tabla de byte a carácter y no se toca nada del archivo si no guarda sus ediciones.
- Si algunos campos se leen bien y otros no, el archivo mezcla probablemente datos de varias fuentes. Eso solo lo puede arreglar quien lo generó.
Otra sutileza: los nombres de campo también son texto y se decodifican con la misma tabla. Si los encabezados de columna salen rotos pero los datos están bien, se escribieron en codificaciones distintas.
Por qué no convertir sin más a UTF-8
La tentación es comprensible, pero DBF no puede contenerlo: la longitud del campo se da en bytes y las letras con tilde ocupan dos bytes en UTF-8. Un campo C(20) admite veinte letras latinas sin tilde, pero menos con tilde: lo que pasa del límite se corta en silencio.
Por eso, al exportar de vuelta a DBF, la codificación es siempre de un byte y las longitudes de campo se recalculan a partir de los datos reales en la codificación de destino. Para obtener texto UTF-8 de un DBF, exporte a CSV, JSON o XLSX.
Preguntas frecuentes
¿Puedo averiguar la codificación sin abrir el archivo?
Mire el byte 29 del encabezado en un editor hexadecimal. Tenga en cuenta que a menudo es cero o incorrecto: el contenido es más fiable.
¿Por qué un programa lee bien el archivo y otro no?
Cuando falta el controlador de idioma, los programas recurren a soluciones distintas: uno usa la página de códigos del sistema Windows y otro supone una de DOS. El archivo es el mismo.
¿Cambiar la codificación en un visor modifica el archivo?
No. Solo cambia cómo se muestran los bytes. El archivo se queda como está hasta que usted guarde cambios de forma explícita.
Gratis para usar. Su archivo no se sube a ningún servidor. Versión para Windows — 4.6 MB, sin instalación: detalles. Pro — 29 USD una sola vez: precio.