Caracteres estranhos em DBF: como achar a codificação certa
Um arquivo DBF não tem um marcador que diga “isto é UTF-8”. A página de código ou é indicada por um único byte do cabeçalho, ou não é indicada de jeito nenhum — e então precisa ser deduzida pelo conteúdo. É assim que “Coração” vira “Cora‡Æo” ou “CoraþÒo”.
De onde vem o problema
O DBF é um formato de um byte por caractere. Qual letra um byte representa depende da página de código. O “ç” é gravado como 0x87 nas páginas DOS cp850 e cp860, mas como 0xE7 no windows-1252. Leia com a tabela errada e você obtém outro caractere:
| Byte | cp437 (DOS, EUA) | cp850 (DOS, Europa Ocidental) | cp860 (DOS, português) | windows-1252 |
|---|---|---|---|---|
0x87 | ç | ç | ç | ‡ |
0xC6 | ╞ | ã | ╞ | Æ |
0x84 | ä | ä | ã | „ |
0xE4 | Σ | õ | Σ | ä |
0xE7 | τ | þ | τ | ç |
0xE9 | Θ | Ú | Θ | é |
O programa que gravou o arquivo conhecia a sua própria tabela. O programa que lê precisa pegá-la do cabeçalho — ou adivinhar. Sistemas em Clipper e dBase para DOS no Brasil costumam usar cp850 (o padrão “Multilíngue” do DOS) ou cp860 (“Português”); sistemas Windows usam windows-1252, o “Latin1” do dia a dia.
O driver de idioma: o byte 29 do cabeçalho
O byte 29 do cabeçalho de um DBF (contando a partir de zero) guarda o Language Driver ID, um código que nomeia a página de código. Os valores mais comuns:
| Código | Codificação | Origem típica |
|---|---|---|
0x01 | cp437 | programas DOS nos EUA, dBase e FoxPro antigos |
0x02 | cp850 | programas DOS na Europa Ocidental e no Brasil |
0x24 | cp860 | programas DOS configurados para português |
0x03, 0x57 | windows-1252 | programas Windows, Visual FoxPro |
0x64, 0x1F | cp852 | programas DOS na Europa Central |
0x00 | não informado | cerca de metade dos arquivos reais |
O byte também pode estar errado: um arquivo foi criado por um programa, ampliado por outro, e o cabeçalho manteve o valor original. É uma dica forte, não uma garantia.
Lendo os sintomas
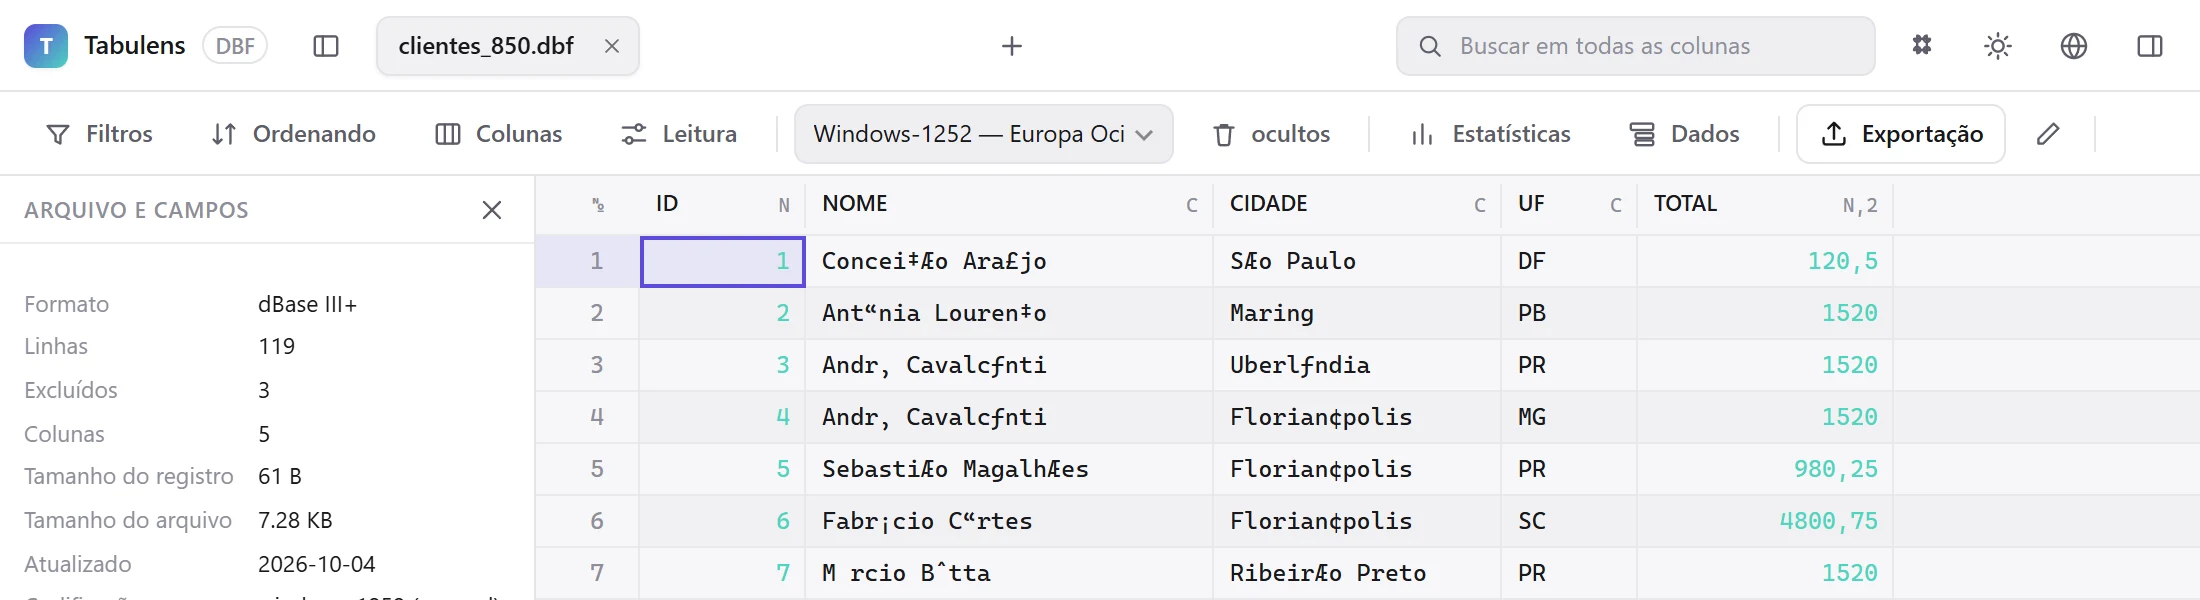
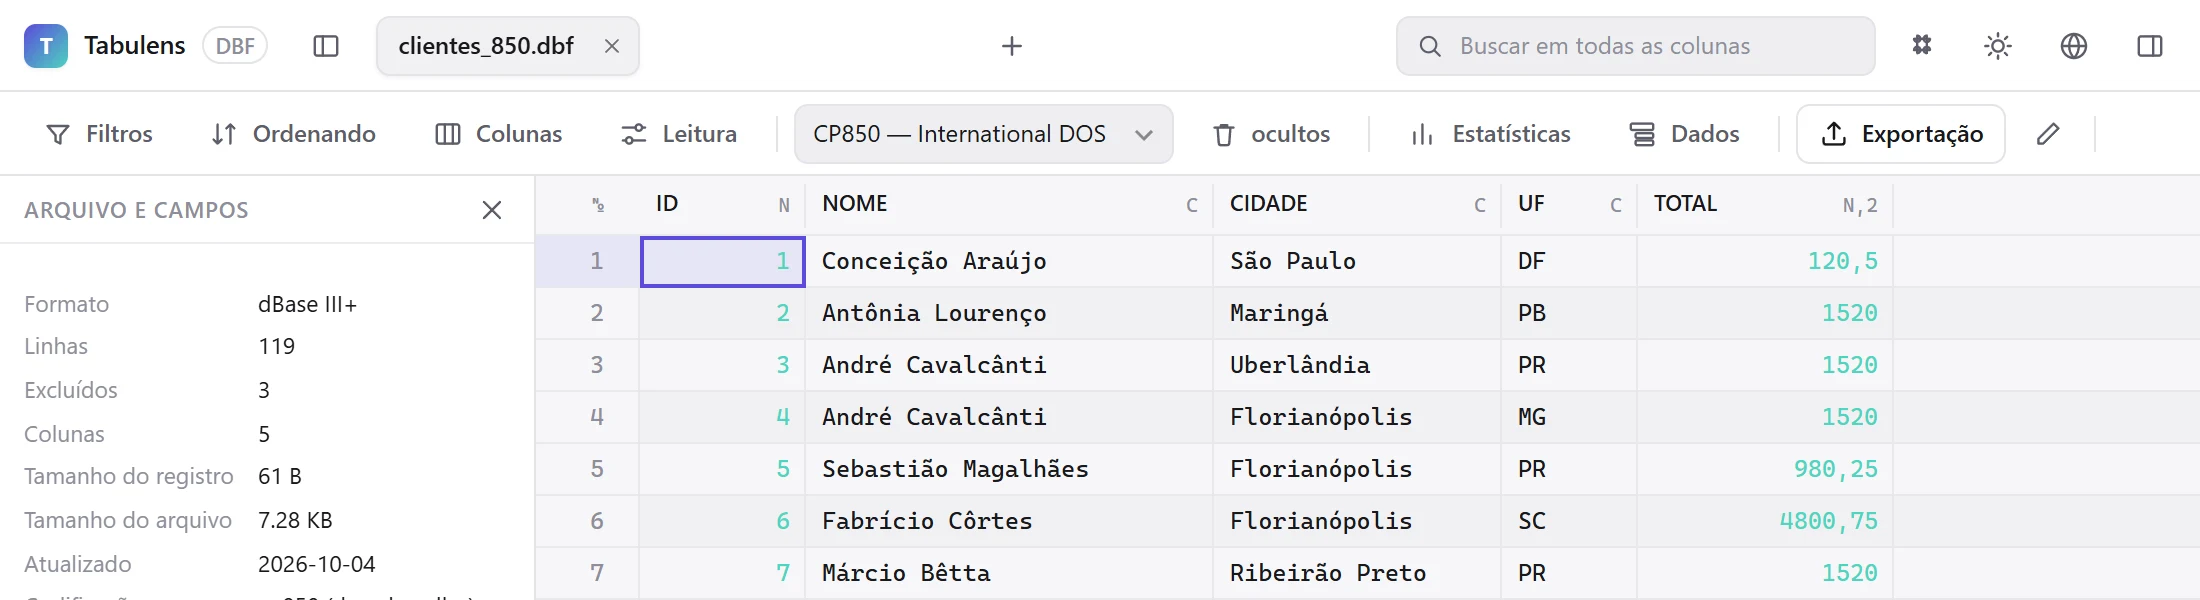
O padrão do lixo mostra o que aconteceu:
- Caracteres de desenho de caixa no meio das palavras (
╔ ║ ╗ ╚ ╣): o arquivo foi gravado em uma página de código do Windows e está sendo lido como DOS. A metade superior das tabelas DOS está cheia de caracteres de desenho, e as letras acentuadas caem ali. - “‡”, “Æ”, “„” onde deveria haver ç, ã, ä: o contrário — dados DOS lidos como windows-1252 (“Cora‡Æo”).
- “þ”, “Ò”, “Ú” no lugar de ç, ã, é: dados windows-1252 lidos como cp850.
- “ç”, “ã”, “é”: dois bytes por letra — o texto é UTF-8 e está sendo lido como uma tabela de um byte. É raro no DBF, mas ferramentas modernas gravam assim.
- Caracteres de substituição (�): o decodificador encontrou bytes que não existem na tabela ou texto multibyte truncado.
O que fazer na prática
- Abra o arquivo e olhe os campos de texto. Se estão corretos, a codificação foi tirada do cabeçalho ou detectada pelo conteúdo.
- Se não estão, troque a codificação na barra de ferramentas e experimente as candidatas prováveis: cp850 e cp860 para arquivos de programas da era DOS, windows-1252 para os do Windows.
- Trocar não reabre o arquivo. Muda só a tabela de byte para caractere, e nada no arquivo é tocado, a não ser que você salve as edições.
- Se alguns campos aparecem certos e outros não, o arquivo provavelmente mistura dados de várias fontes. Isso só pode ser corrigido por quem o produziu.
Mais uma sutileza: os nomes dos campos também são texto e são decodificados com a mesma tabela. Se os títulos das colunas estão estragados mas os dados estão bons, os dois foram gravados em codificações diferentes.
Por que não converter simplesmente para UTF-8
A tentação é compreensível, mas o DBF não comporta isso: o tamanho do campo é dado em bytes, e as letras acentuadas ocupam dois bytes cada em UTF-8. Um campo C(20) comporta vinte letras latinas simples, mas menos letras acentuadas — o que passar do limite é cortado em silêncio.
Por isso, quando os dados são exportados de volta para DBF, a codificação é sempre de um byte, e o tamanho dos campos é recalculado a partir dos dados reais na codificação de destino. Para obter texto UTF-8 de um DBF, exporte para CSV, JSON ou XLSX.
Perguntas frequentes
Dá para achar a codificação sem abrir o arquivo?
Olhe o byte 29 do cabeçalho em um editor hexadecimal. Lembre que ele muitas vezes é zero ou está errado — o conteúdo é mais confiável.
Por que um programa lê o arquivo certo e outro não?
Quando falta o driver de idioma, os programas recorrem a alternativas diferentes: um usa a página de código do sistema do Windows, outro presume uma de DOS. O arquivo é o mesmo.
Trocar a codificação em um visualizador altera o arquivo?
Não. Só muda a forma de exibir os bytes. O arquivo fica como está até você salvar as alterações explicitamente.
Grátis para uso pessoal. Seu arquivo não é enviado a nenhum servidor. Versão para Windows — 3.5 MB, sem instalação: detalhes. Para organizações — licença.